一套 30 米地形,背后是十三年影像、上百万景的观测,和一份写得清楚的许可说明。
一、两家机构合造,一家公司算出来
这套数据的正式名称是 ASTER Global Digital Elevation Model V003,缩写 ASTGTM,版本 003,处理级别 Level 3。它挂在 NASA 的 Land Processes DAAC 名下,数据集页标注的发布时间是 2019 年 8 月 5 日,DOI 为 10.5067/ASTER/ASTGTM.003。
来路是两边合起来的:一方是美国 NASA,一方是日本经济产业省(METI)。两边共同推动,实际的处理生产交给东京的 Sensor Information Laboratory Corporation(SILC)。这类合作产品的署名要带全两边,后面讲许可与引用时还会回到这一点。
输入是 ASTER Level 1A 的全库存档,采集时间从 2000 年 3 月 1 日 排到 2013 年 11 月 30 日,前后十三年多。这个跨度值得留意:同一片地面在不同年份被拍到,云量、雪线、植被状态都不一样,堆到一起之前得先把这些差异处理掉。
处理从立体相关开始。成对的影像配起来,算出每一景的高程,这样的单景 DEM 攒了 100 万景以上。接着做云掩膜,把被云遮住的部分标出来;云筛过的和没筛过的 DEM 一并堆栈,让同一位置的多次观测落进同一个格子。堆栈之后剔除残余坏值与离群值,堆叠还不充足的地方,用既有参考地形补上,把残余异常拉回来。最后对每个格子取平均,得到最终像元值,切成 1°×1° 的分幅,相邻分幅保留 1 个像素 的重叠。
水面另有一步:用 ASTER Global Water Bodies Database(ASTWBD)V1 校正水体表面高程。湖面、河面本来是平的,不校正,堆出来的水面会带一层起伏。
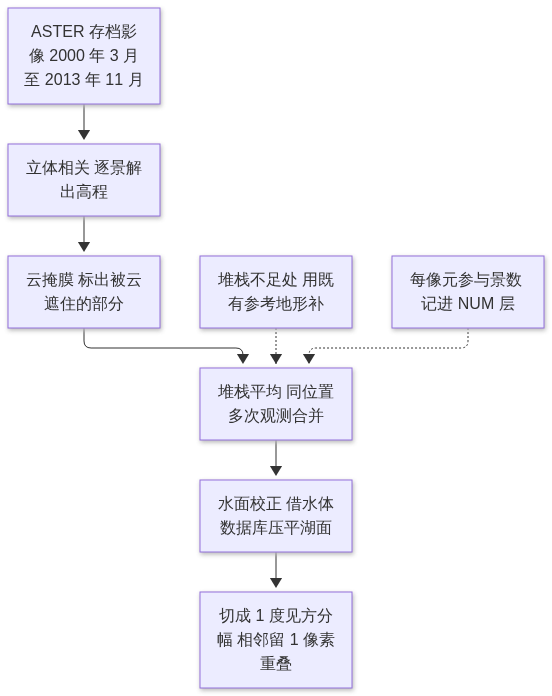
图注:从存档影像到分幅切块的处理链
二、一弧秒的格子,两万三千块分幅
先看规格。下面这张表里,除格网之外还有两处容易读漏:分幅数按量级写,覆盖范围在两处标注上略有出入。
| 项目 | 说明 |
|---|---|
| 格网 | 1 弧秒,赤道附近水平约 30 米;分辨率字段标 30 米 × 30 米 |
| 分幅 | 1°×1°,相邻分幅有 1 像素重叠;全集约 2.3 万块,每块至少含 0.01% 陆地 |
| 覆盖 | 约南北纬 83° 之间的陆地 |
| 格式 | Cloud Optimized GeoTIFF(COG)、NetCDF4 |
| 基准 | 水平 WGS84,垂直 EGM96 大地水准面 |
| 图层 | DEM 与 NUM 两层 |
表注:规格取自该数据集页与 DOI 页;分幅数在数据集文件数字段记为 22,912,此处按量级写作约 2.3 万块;覆盖范围两处标注不一致,正文统一按约南北纬 83° 表述。
弧秒是角度单位,不是长度单位。同一条 1 弧秒的边,在赤道附近约合 30 米,往高纬走经线收敛,东西向的实际间距就变窄了。所以「30 米」说的是赤道附近的口径,不是全球各处都一样宽。业内同量级还有一套雷达来源的 30 米数据,本篇只讲 ASTER 这一套,不作横向比较。
覆盖范围那处出入需要交代一句:数据集页的描述写 83°N 至 83°S,而数据集字段标的是 N 82、S −83。两处标注不一致,正文按「约南北纬 83°」表述;真要取某一块,仍以检索结果为准。
分幅的切法也有讲究。每块至少要含 0.01% 的陆地,纯海洋的格子不切,所以两万三千块里,海上那部分是空的——某片海域查不到分幅,不是漏了,是本来就没切。相邻分幅留 1 个像素的重叠,是为了拼接时边缘能咬合:两块各自算出来的高程在重叠带上对一遍,接缝处才不至于错台。
DEM 之外还有一层 NUM。它记的是每个像元参与处理的景数,以及数据来源。这一层不直接告诉你地形高低,但它能回答另一个问题:某个格子上的高程,是几景堆出来的。景数多的地方,多次观测互相校过;景数少的地方,可能就两三景撑着,遇到云、雪、水面的干扰,出错的空间更大。打开一片地形之前先翻一眼 NUM,哪里值得多留一分怀疑,心里就有数了。
两层配合的用法很直接:DEM 定地形,NUM 定可信度。一片区域在 NUM 上是一整块低值,地形又异常平滑,多半是景数不足、靠参考地形补出来的结果;景数均匀、数值连续的地方,基本可以直接用。这一层不增加工作量,只是把判断从「看着像」变成「有据可查」。
版本 003 相对上一版有三处改动:无云输入景从 150 万 增到 188 万;河流与湖泊分开处理,不再按同一套规则压平;最小水体识别从 1 平方千米 降到 0.2 平方千米。前一条让可用的干净影像更多,后两条让水面周边更贴合实际——水库、宽河、湖岸,往往是地形数据最容易出问题的地方。
官方对这套数据的边界说得很直白:除格陵兰与南极外基本没有空洞,但仍可能含异常与伪影,数据「按现状提供」,NASA 与 METI/ERSDAC 不承担因使用造成的损失。另有两条细节:相邻分幅边缘的重叠像元,多数取值相同,个别可能不同;接边处若出现细微跳变,先看一眼是不是正落在重叠带上。
读到这句,不必急着怀疑自己的流程。伪影是这类全球产品自带的边界——十三年、上百万景影像拼成的一张网,不可能每一格都同样干净。知道边界在哪,在该核对的地方核对,就够了。
三、两个官方入口,按数据集名加分幅号取
入口有两个:NASA 的 Earthdata Search,和 LP DAAC 的数据池。两边放的是同一批分幅,差别在组织方式——Search 按数据集加范围检索,数据池按目录层级往下走。两个入口都要注册账号并登录才能下载。
检索方式一句话:数据集名+分幅号。先在 Search 里把数据集定到 ASTGTM v003,再按分幅号定位到具体一块;数据池那边则顺着行列目录找下去。分幅号本身就是位置,不必先看图猜。
格式上两种都齐:COG 是带分块与概览的 GeoTIFF,常见 GIS 软件打开就能用;NetCDF4 更常出现在科研与批量计算的环境里。手上用什么工具,就取哪一种,格子本身是同一套。
容易漏的是接边。项目跨幅时,边界上相邻的几块必须取齐:一块 1°×1° 的分幅只覆盖一格经纬度,项目范围压在两格之间,就至少取两块;摊到三格上,就得三块。范围越大,行列越要一格一格对过去。
少取一块会怎样?接边处留一道缝。缝在三维场景里很显眼:一条本该连续的山脊突然断开,或者两块地形之间叠出一条整齐的台阶。这不是数据坏了,是缺了相邻那一块。
核对是否取齐,不必一块一块打开看。把拿到的分幅号按行列排一遍,横竖连续就是齐了;中间空一格,回头补下即可。这一步花的时间不多,比在场景里找缝快得多。
四、许可结论与整理包
许可这件事,按 NASA 的数据使用与引用指引读下来是这样:页面上没有标注使用限制或授权条款的数据,按 CC0 处理。落到这批数据上,结论是使用上没有限制,不必逐案申请授权,也不必事先报备。
但「没有限制」不等于「不必署名」。同一份指引写得很清楚:官方强烈建议在成果中引用数据,并注明 NASA 为来源;同时,材料的使用不得暗示 NASA 对某个产品、服务或活动有背书。引用写在成果里,是给自己留一条可追溯的线。
还有一层要分清:非 NASA 提供的数据,受其主办机构的许可安排约束。ASTER 是合作产品,日方一侧的权益也在里面,所以引用不能只写「NASA 数据」,而要按 DOI 页给出的规范引用句来标,把数据集名、版本、生产与发布机构、DOI 一并列全。
引用句落在哪里都可以:成果的说明文档、图件的角注、交付资料的扉页。关键是三样对得上——数据集全名与版本、发布机构、DOI。少写一样,别人顺着找回去就对不上号。
整理包的做法是裁剪、重投影、转格式——从两万三千块分幅里取出用得上的一块,按项目需要的坐标系转好,换成软件读得顺的封装。这是派生成果,不是原始数据的再分发。包内随附出处与引用句原文、版本号 003、获取日期,以及这一份具体做过哪些处理;少一样,后面接手的人都说不清它是哪来的、动过什么。
工程上还有一处必须对齐:基准。这套数据水平是 WGS84,垂直是 EGM96 大地水准面,项目上常用的却是国家 2000。整理包做过重投影,基准这一层仍要在导入时确认。
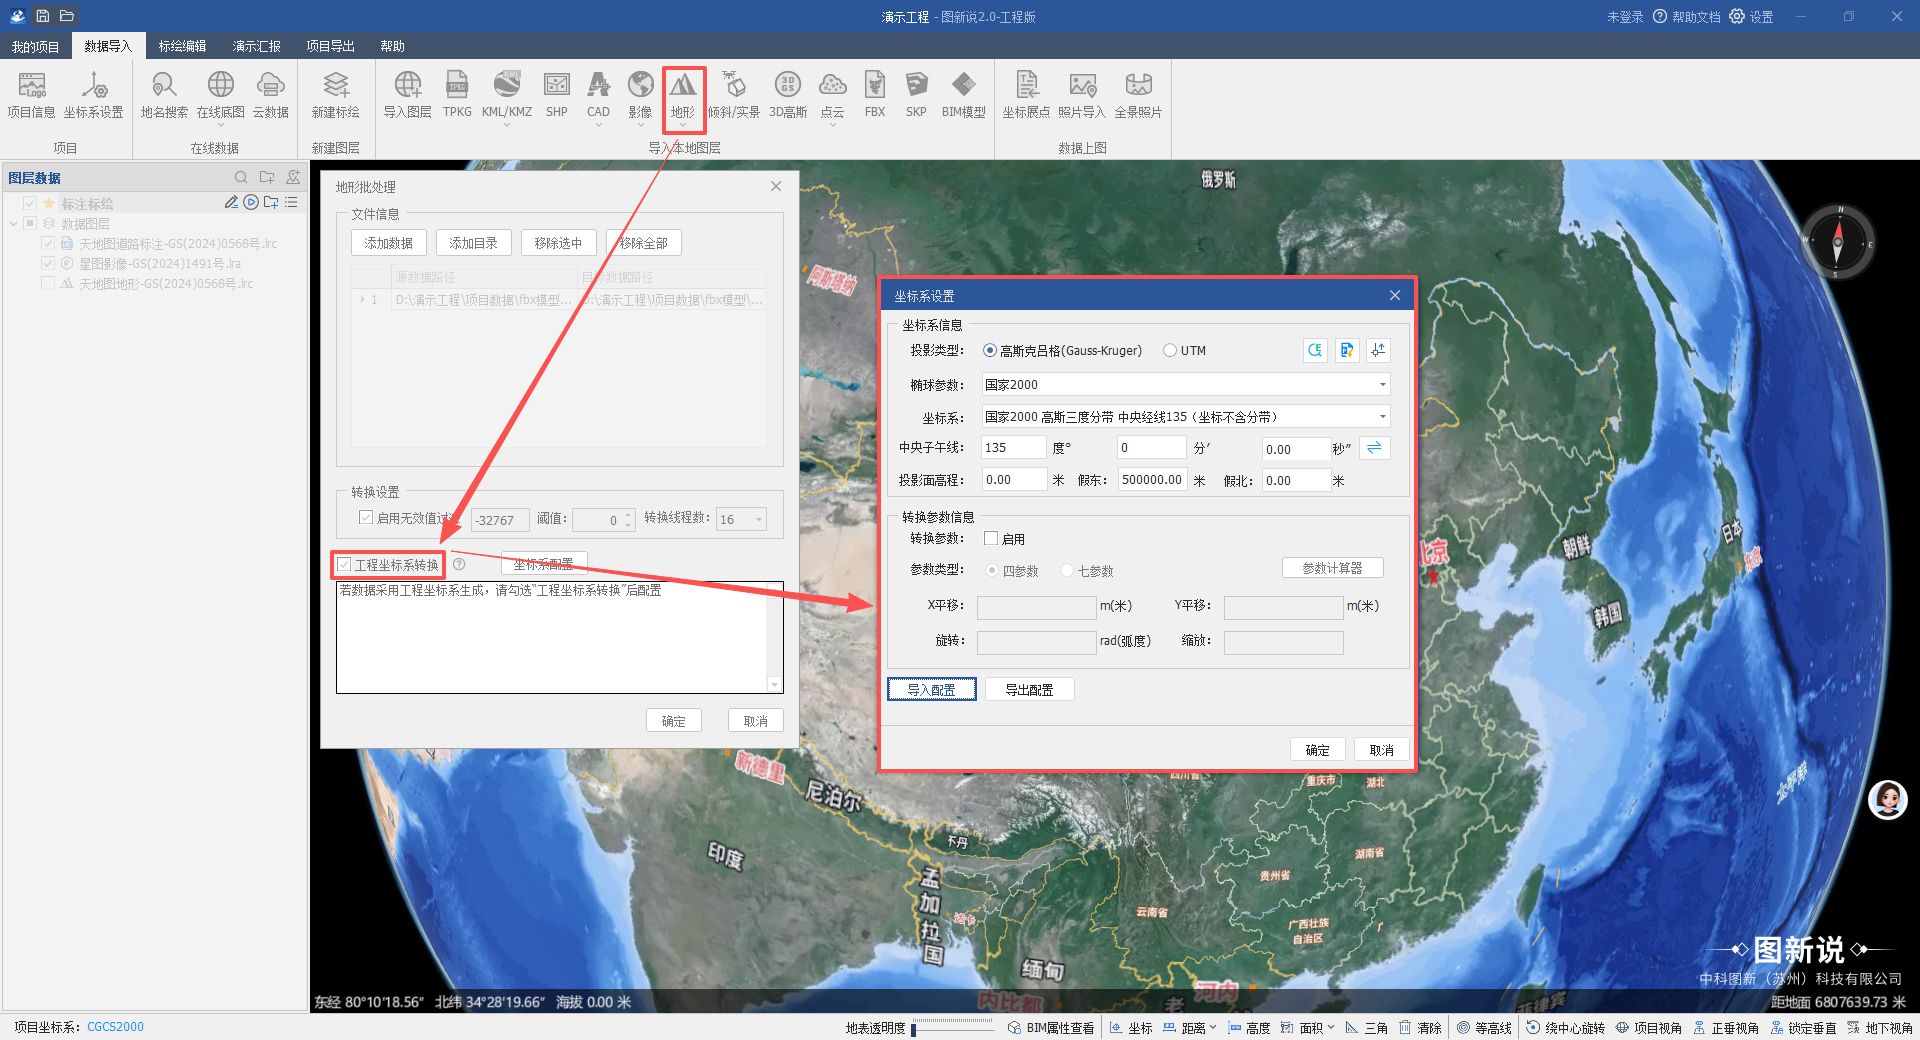
图注:地形数据导入与坐标系配置界面,界面示意
图新说支持多坐标系融合,导入时选对工程坐标系,WGS84 的地形才会落到国家 2000 的场景位置上;这一步选错,地形和设计图会整体错开,靠肉眼很难发现。
参考来源: - NASA Earthdata:ASTER Global Digital Elevation Model V003 数据集页 - ASTER GDEM V003 的 DOI 与规范引用句(DOI 页) - NASA 数据使用与引用指引

扫码添加技术顾问,获取 1 对 1 方案咨询
图新说 | 工程管理数字沙盘——看现场 · 做方案 · 管过程 · 定决策 · 存档案 让每一寸空间都有数字灵魂