把城市级倾斜模型和上百万条矢量要素放进一个三维场景,卡顿是正常的,很少有软件能做到将大体量的倾斜和百万条矢量融合到一个场景能不卡顿。
一、问题先行:百万级 SHP 与倾斜模型同屏,为什么卡
一个常见场景是:某地要把 497 平方公里高精度全要素基础地理实体数据库(长沙市,建筑物、道路被划分为具有独立身份编码的单一个体,并整合 4.2 万公里地下管线与 21 平方公里地下空间三维数据)和倾斜模型一起加载,刚一缩放就掉帧。卡在哪里?从四个维度拆:
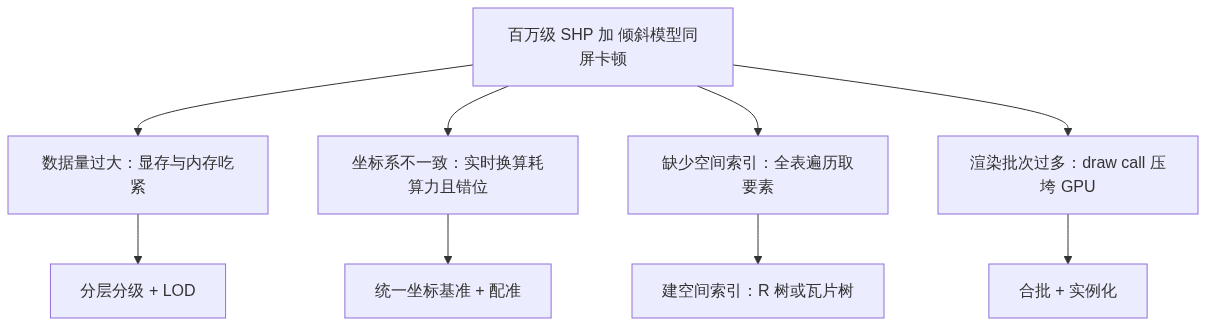
一是数据量。倾斜模型按 OSGB / 3DTiles 瓦片存储,单平方公里城市级模型可达上百GB;SHP 百万级面或点要素,配套的 dbf 属性表同样巨大。两者不经处理同屏,显存和内存会同时吃紧。
具体做法:先算两个数字——数据总体积(GB)和要素总条数,用它们决定要不要分层。
具体场景:以该体量数据为例:山西省(曾波署名文章,山西日报)以 0.5 米格网 DEM、0.2 米正射影像、0.05 米倾斜摄影构建实景三维,三类数据本来就是分层采集的,加载时也应分层。
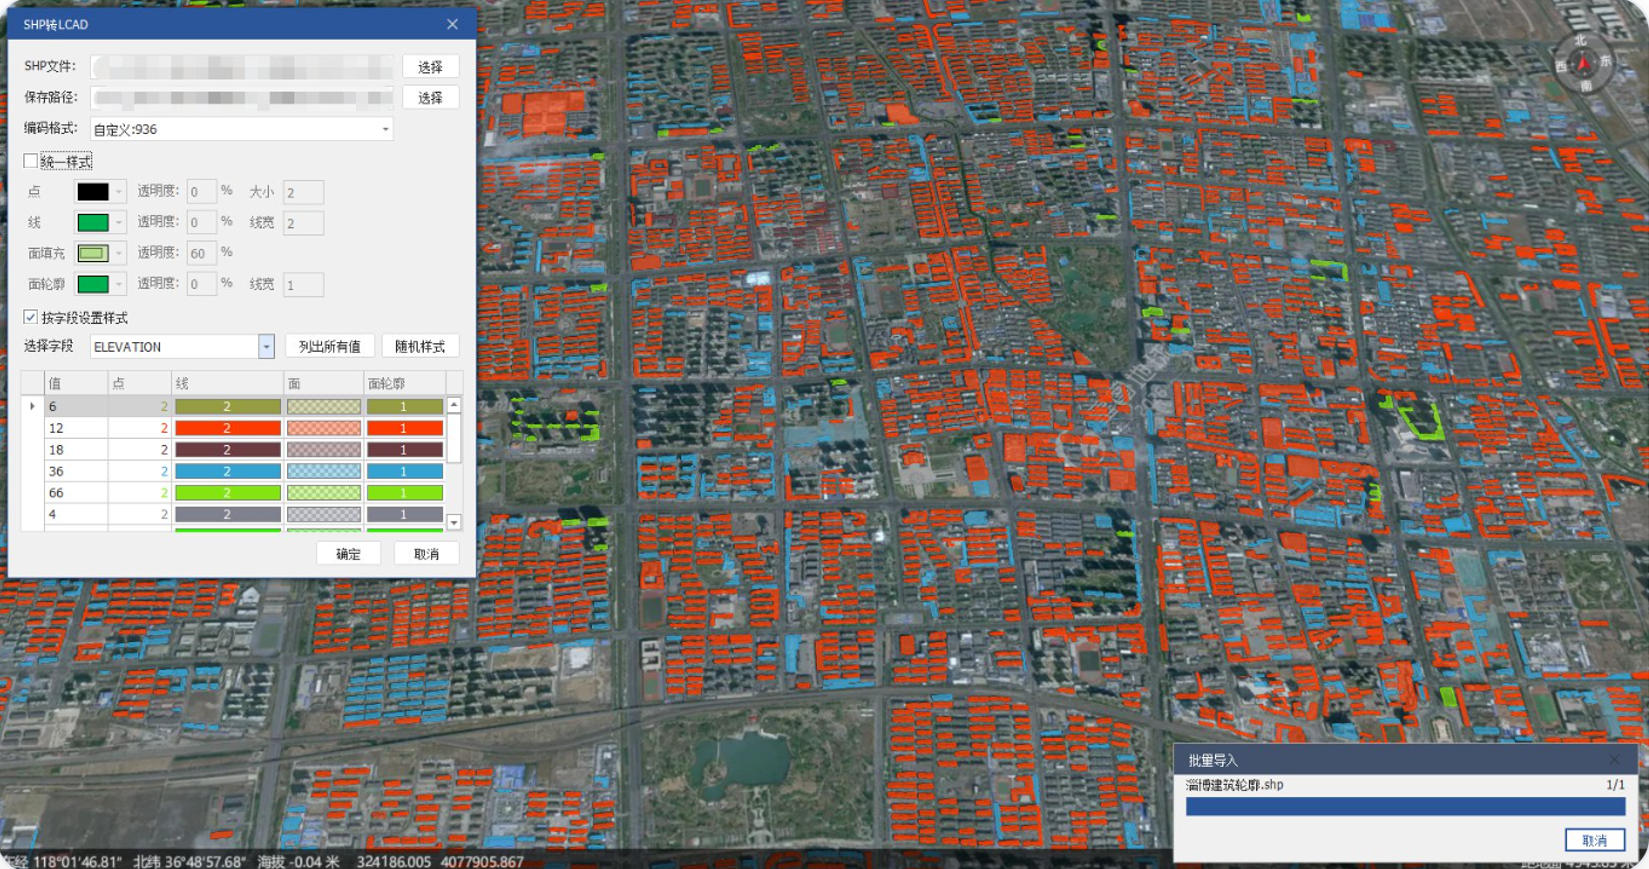
二是坐标系。矢量用一套基准、倾斜模型用另一套基准,同屏前若没统一,渲染端要做实时换算,既额外耗算力,又可能错位。具体做法:所有数据统一到 CGCS2000(或项目约定基准),导入时带 prj 或控制点配准。具体场景:CAD 与倾斜模型叠加,先做一次坐标统一,缩放时不再每帧重算。
三是索引。SHP 默认按文件顺序读,没有空间索引时,漫游到某个区域要遍历全表才知道该画哪些。具体做法:建空间索引(如 R 树或网格索引),让"视域内有哪批要素"变成一次检索而非全表扫描。具体场景:只加载当前视域命中的要素子集,百万级数据也能只取几万条。
四是渲染批次。每类要素、每个模型各发一次绘制指令(draw call),批次过多会压垮 GPU 调度。具体做法:合批(相同材质合并)与实例化(重复构件一次上传、多次引用)。具体场景:成片建筑轮廓用实例化渲染,draw call 从百万级降到千级。
下面这张图把四个成因和对应处理串起来:
二、组织方式:分层分级、按需加载与空间索引
组织先于优化。同屏想顺畅,先做三件事:
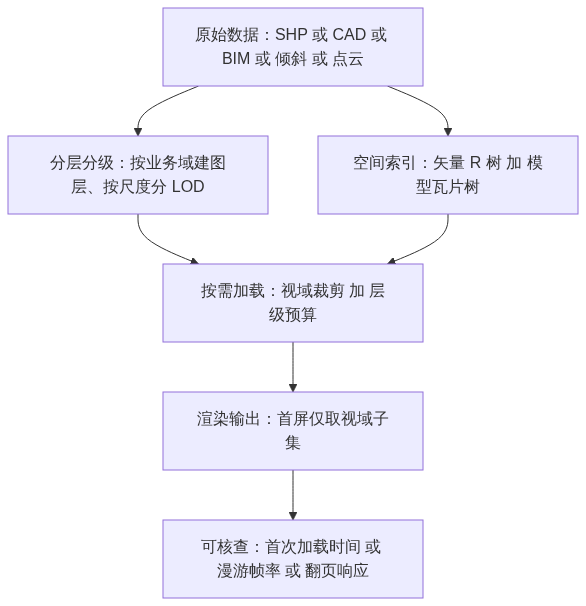
一是分层分级。把数据按"底图与坐标—专题要素—分析叠加"分桶,按业务域建图层,按尺度分 LOD。具体做法:用"L序号_业务域"命名图层,序号连续不跳号,一个要素只归一层。具体场景:底图 L01_坐标基准、L02_建筑轮廓、L03_地下管线,跨人打开都认得。
{
  "feature_id": "CS-BD-00231",
  "category": "building_outline",
  "crs": "CGCS2000",
  "lod": 2,
  "layer": "L02_建筑轮廓",
  "fields": ["entity_code", "usage", "height"]
}
上面是一个要素对象的最小定义:用"稳定不重复"的编码(feature_id)而不是行号作主键,属性只挂必要字段,这样要素在多次任务间都能被准确对应。
二是按需加载。视域外不加载,低层不加载高层细节。具体做法:用视域裁剪加层级预算,首屏只取 LOD0 到 LOD2 瓦片与索引命中的要素。具体场景:打开城市级方案时先加载主城区概览,放大到街区再取精细层。
三是空间索引。给矢量建空间索引、给模型建瓦片树,让"该画哪些"变成检索而非遍历。具体做法:矢量侧建 R 树,模型侧依赖 3DTiles 的层级树。具体场景:漫游时每帧只取视锥内瓦片,加载压力随视域走。
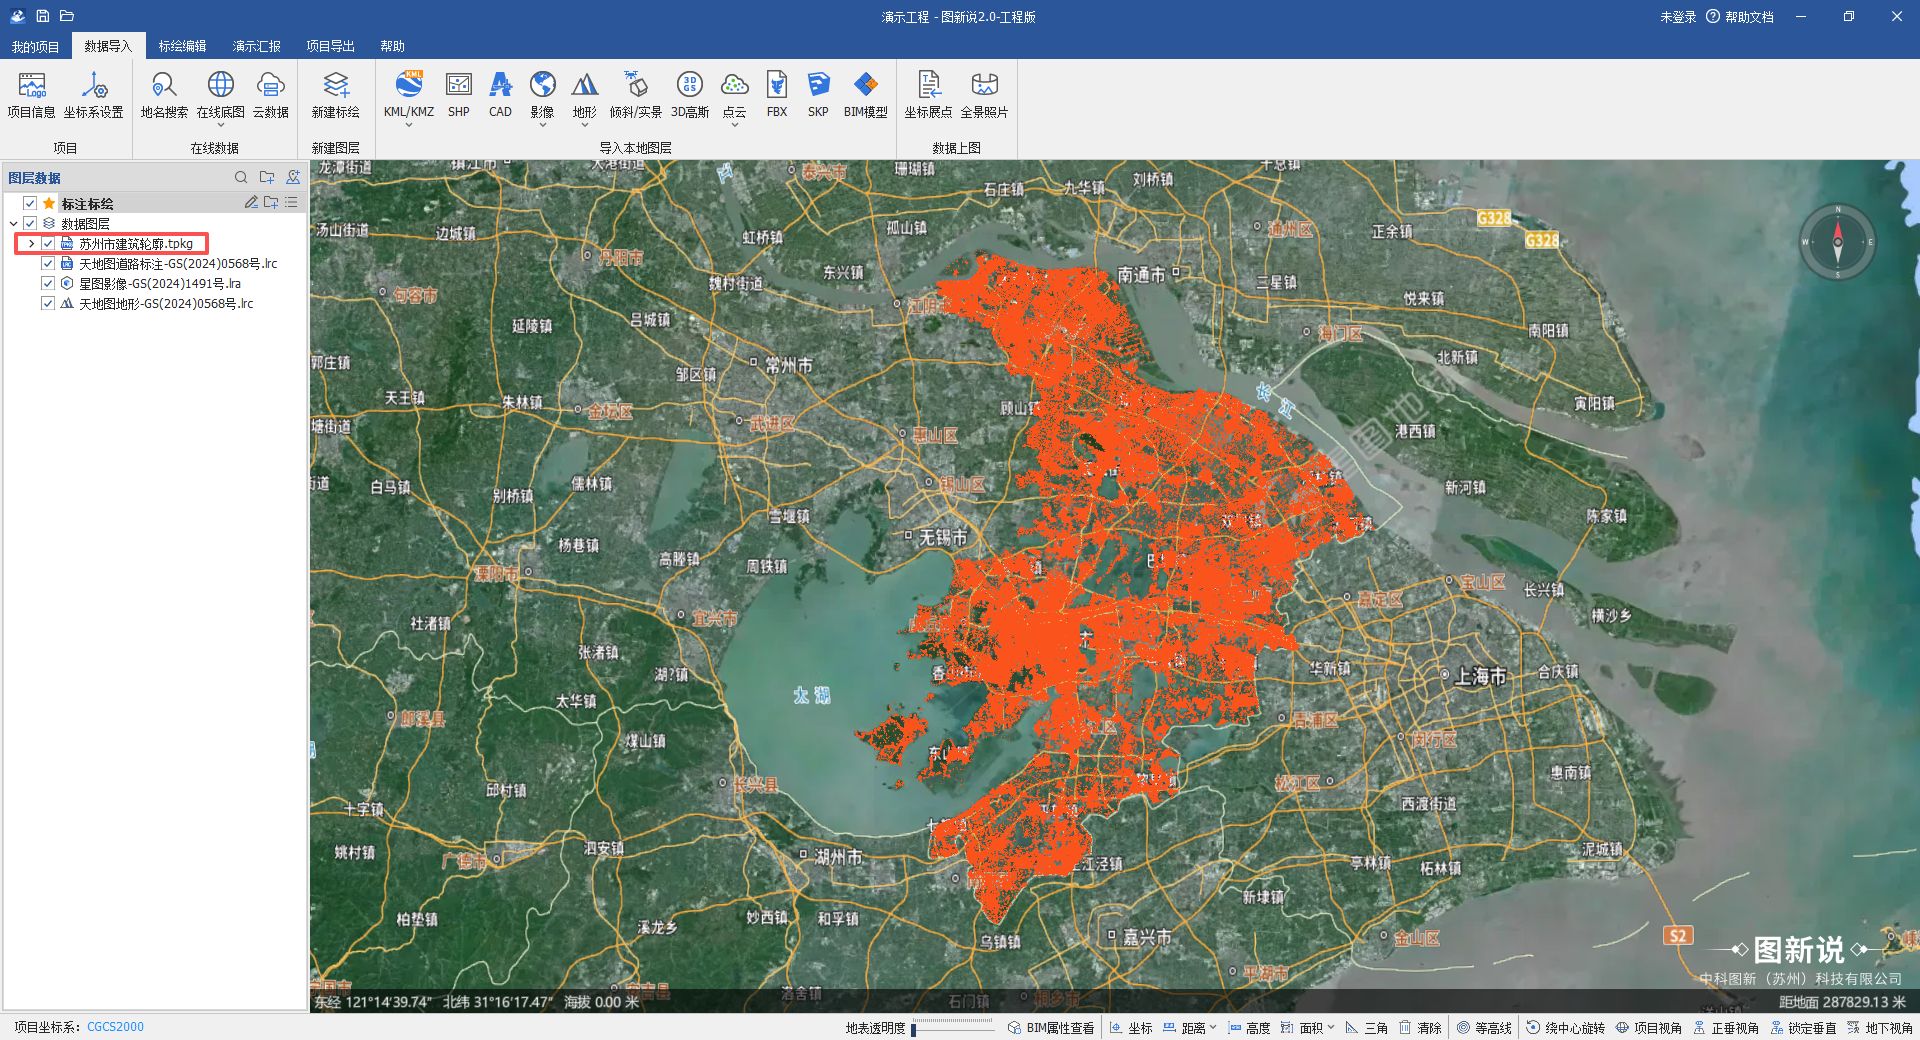
数据组织也关系到成果管理。自然资源部办公厅 2026-07-23 印发的《非涉密测绘地理信息成果管理办法》(部门规范性文件)提出,按数据分类分级管理要求保管、提供和共享成果,保管单位负责目录编制与更新维护并发布元数据——分层分级本就是成果能"被查到、被用到"的前提。
数据组织与轻量化的链路可以画成一条:
三、轻量化取舍:几何简化还是属性完整,纹理压缩还是辨识度
轻量化不是一味压小,是保住"用得上的信息"。
几何简化 vs 属性完整:简化面数能减显存,但属性(如实体编码、用途)是检索依据,不能丢。具体做法:几何按视距分级简化,属性按"检索必需"留核心字段,非必要字段拆到外部表、用编码关联。具体场景:长沙市 497 平方公里基础地理实体数据库里,建筑物作为"具有独立身份编码的单一个体",编码和用途必须随要素保留,外观精度可随层级降。
纹理压缩 vs 辨识度:倾斜模型纹理占体量大头,压缩能显著减体积,但过度压缩会让地物难辨。具体做法:按用途定压缩率——汇报大屏用高压缩,方案比对用中等压缩;近景保留原纹理。具体场景:河东主城区 260 平方公里达 2.8 厘米精度区域,做整体漫游时用压缩纹理保流畅,定点核查时切回原纹理保辨识。
-- 按需加载:只取当前视域与必要字段,避免整表读入
SELECT entity_code, usage, height
FROM building_outline
WHERE geom && ST_MakeEnvelope(120.10, 31.20, 120.18, 31.28, 4326)
  AND lod <= 2;
上面这段示意:用空间过滤加字段投影,把"读全表"变成"读该区的必要列",内存和首屏时间都下来了。
四、工程侧可核查指标:首次加载时间、漫游帧率、翻页响应
性能不能靠"感觉流畅"判断,要落到三个可测指标。
首次加载时间:从点击打开到首屏可交互的耗时。具体做法:记录分层分级加空间索引前后两次耗时对比,首屏要素量从百万级降到视域内十万级以内时,时间应明显下降。具体场景:一份城市级方案,优化前整库加载、优化后仅首屏加载,计时对比。
漫游帧率:平均 FPS 与最低 FPS。具体做法:在目标硬件上开 FPS 计数,低于阈值(如 30 FPS)时检查合批与实例化是否开启、纹理是否按距离降级。具体场景:在 2.8 厘米精度区域漫游,先视域裁剪再开实例化,记录 FPS 曲线。
翻页响应:三维 PPT 每页切换的耗时。具体做法:不同页加载不同数据组合时,缓存已加载图层、避免重复解析,记录单页切换从点击到要素与模型就绪的耗时。具体场景:一份 20 页方案汇报,逐页计时,确保翻页不卡顿。
这三个指标都可测、可复现,比"运行流畅"更有说服力。
五、常见问题:坐标系混用错位、属性表过大、更新后缓存不一致
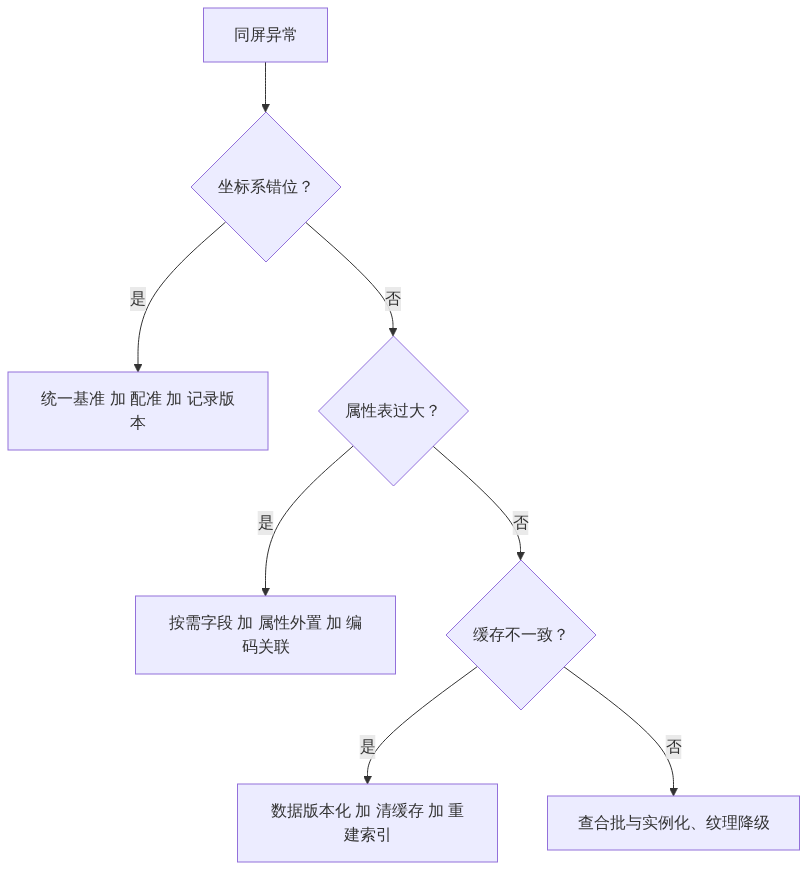
坐标系混用导致错位:成因是矢量与模型基准不同、导入时没配准。具体做法:统一到统一基准,导入带 prj 或控制点,换底图时重做配准并记录版本。具体场景:倾斜模型更新后,所有要素按 CGCS2000 重新对齐,路线不漂。
属性表过大:成因是百万行 dbf 全字段读入、冗余字段多。具体做法:按需加载字段、非必要属性外置、用编码关联;控制单表体积。具体场景:建筑轮廓只保留编码、用途、高度三列进场景,明细表按编码另行查询。

更新后缓存不一致:成因是底图或模型更新,但旧瓦片与索引未刷新,看到的是过期数据。具体做法:数据版本化,更新后清缓存、重建空间索引,记录数据版本号再交付。具体场景:青海省《自然资源保护利用"十五五"规划》(青海省人民政府印发,省政府官网 2026-09-18 发布,省级规划)提出推进地形级、城市级实景三维数据与基础测绘数据联动更新——联动更新落到工程侧,就是"改了源数据就要同步刷索引与缓存"这条纪律。
三类问题的排查顺序可以画成一张流程:
工具推荐
上面介绍了很多方法,如果要把文中的大体量矢量与倾斜模型组织、坐标统一与轻量化直接落地,图新说是一个开箱即用的工具,不需要做各类的数据预处理即可直接提供多源数据融合与坐标统一能力,支持 SHP、CAD、BIM、倾斜模型、正射影像、点云、3D 高斯泼溅等数据在一个三维场景里分层组织与按需加载,成果可导出为三维交互式汇报与带访问密码的沙盘。具体做法:按图层分组管理要素、用坐标统一把多源数据对齐到统一基准、导出时设置访问密码。具体场景:把一份城市级方案的多期数据按图层归档,汇报时按页切换加载。
收尾
同屏卡顿,根因大多在数据组织:分层分级决定加载多少,空间索引决定加载哪些,轻量化决定保住什么信息。落到软件上,就看三个指标——首次加载时间、漫游帧率、翻页响应。做好了这三层,百万级要素和城市级模型也能在一个场景里顺畅同屏。如果你手头正有一份要同屏的大体量数据,不妨先从坐标系统一和空间索引两件事查起。
图新说 —— 为三维汇报而生
让每一寸空间都有数字灵魂
参考来源:
- 青海省人民政府:《关于印发〈青海省自然资源保护利用"十五五"规划〉的通知》(省政府官网 2026-09-18 发布,省级规划)
- 自然资源部办公厅:《自然资源部非涉密测绘地理信息成果管理办法》(2026-07-23 印发,部门规范性文件)
- 山西日报(太原新闻网 9 月 20 日转发):山西省测绘地理信息院院长曾波署名文章·实景三维数据规格
话题标签: #BIM #三维可视化 #GIS #实景三维 #智能建造