两幅以上的 DEM 拼成一幅、再重采样成统一格网,是数据准备里最平常的一步。平常到很少有人为它单独立一个检查环节——直到接缝处的等高线跳了一格,或者算出来的汇水面积对不上,才发现问题并不出在拼接那一步,而是出在动手之前。
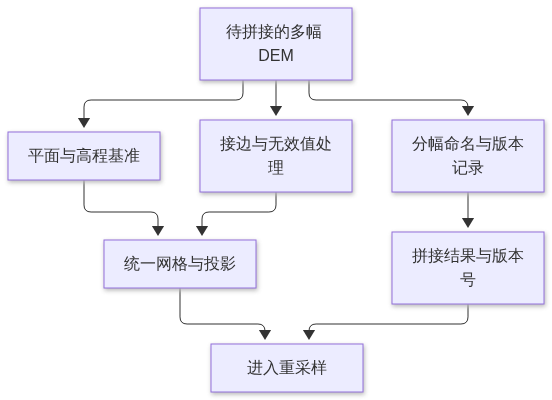
这里说的"动手之前",指的是打开处理工具之前。拼接本身不复杂:把几幅分幅按位置摆进同一张画布,重叠带做一次取舍,再把格网拉到统一间距。难的是五项前提——这几幅分幅是不是同一套坐标系、高程是不是同一个基准、接边处重叠带有多宽、无效值怎么标、拼完之后这一版怎么记名字。五项里任一项没定,拼出来的东西都要返工,而且返工时往往说不清错在哪一步。
一、五项检查,一项一项过
1. 坐标系与中央经线
先看分幅之间是不是同一套投影。同一个 CGCS2000 底下,三度带与六度带、带号不同、中央经线不同,平面坐标就不是一个数。跨带的两幅直接拼,接边处会出现整体错台:两边的格网看上去对上了,坐标其实对不上,位置差多少取决于离中央经线多远。
工程独立坐标系的项目更常见:测区为了控制变形自设中央经线,分幅按这套坐标出,但随手拿来的区域数据是国家分带的。两套并在一起,误差不是均匀的,离各自中央经线越远越大,接边处的错台在测区中部看着不明显,到边角就看得出来了。
不检查会出什么事:同一条等高线在接边处跳一格,左右两幅各自都"对",拼在一起就是错台。
2. 高程基准与单位
高程分两层意思。一层是相对哪个面:大地高相对参考椭球面,正常高相对似大地水准面,两者差一个高程异常,山区可能到米级;公开数据里还有用 EGM96 大地水准面作垂直基准的,与国内工程常用的 1985 国家高程基准不是一套。另一层是单位:米、分米、英尺,写在文件头里,转格式的时候最容易丢。
这两层最容易在交接处出问题。几幅分幅来路各不相同,各自都对;拼的时候按数值直接摆,高程整体差一个常数,而差值本身随位置缓慢变化,不会报错,也不会在画面上显眼。
不检查会出什么事:整幅高程差一个常数,且随位置缓慢变化——差值在平原区看着像噪声,到山区才发现是一条趋势线。
3. 接边与重叠
分幅生产时会留重叠带,宽度按生产规格定,不同来源的分幅重叠宽度不一定一样。拼接前要问两个问题:重叠带有多宽、接边取哪一侧。
取哪一侧不是随手定,要写成规则:左幅取到右边界、右幅从左边界起,或者按接边线两侧各取一半。规则不写,两幅一起处理时就会出现双线——同一条路、同一条沟在接缝两侧各留一次;或者反过来,两边都让,中间裂开一条缝。
JAXA 的 ALOS AW3D30 数据集说明页把分幅单位写得很直接:按 1°×1° 的经纬度切块下载,一个瓦片一个文件。同一份数据的不同瓦片本来就在同一套格网上,接边时不用再对原点;换成不同来源的两份数据,格网原点、格网间距、接边取法都要重新对一遍。那份说明里还有一句更实际的提醒:要让瓦片边缘的重采样准确,输入不能只给目标瓦片,还得把周边瓦片一起放进去。
不检查会出什么事:接缝处出现双线或者裂缝;边界一圈因为缺了邻幅,被外插出一圈假值。
4. 无效值与空洞
无效值有三种常见标法:一个大负数(比如 -9999)、0、或者 NaN。三种混在一份数据里,后续的填补逻辑就会把大负数当成真实高程参与平均,整片塌下去。所以先确认无效值标记是什么,再把它们统一成同一种。
空洞怎么留也有讲究。云、雪、阴影遮挡造成的无数据区,有的数据源在发布时已经补过,有的没补。NASA LP DAAC 的 SRTM 产品说明写得很清楚:第三版的主要工作就是消除早期版本里存在的空洞,缺测处用 ASTER GDEM、GMTED2010 或 NED 的数据补上,每个像元的来源另有对应的产品标注。这句话的意思很实际——你手上那份"看着连续"的数据,可能一部分来自雷达、一部分来自填补源,接缝就藏在数据内部。
不检查会出什么事:空洞被当成 0 参与计算。0 值区在坡度图上是一片假平地,在汇水分析里是一个假洼地,在土方里是一大块凭空少掉的体积——而且它不报错。
5. 命名与版本
分幅的命名规则要先认下来:按图幅号、按行列号、还是按经纬度范围。三种都见过,混着用就会出现同名不同幅、同幅不同名。拼接之后这一版怎么记,也要在动手前定:版本号加日期,再加一份参与拼接的分幅清单。清单不用长,把文件名逐个列出来就够,关键是能对上。
不检查会出什么事:半年后有人说"上次那版高程不对",没人说得清那版是哪几幅拼的、用的是哪一版分幅。
五项摆在一张表上,逐行念一遍,比凭印象过一遍稳得多:
| 检查项 | 看什么 | 不检查的后果 | 记在哪 |
|---|---|---|---|
| 坐标系与中央经线 | 带号、中央经线、是否跨带 | 接边处整体错台 | 成果说明首段 |
| 高程基准与单位 | 大地高或正常高、米或其它 | 整体差一个常数 | 成果说明次段 |
| 接边与重叠 | 重叠宽度、接边取哪一侧 | 双线或裂缝 | 接边规则一页 |
| 无效值与空洞 | 无效值标记、是否已填补 | 空洞被当成 0 | 数据说明附注 |
| 命名与版本 | 分幅命名、版本号规则 | 说不清这一版的来路 | 版本记录 |
二、重采样:两种情形,一处顺序
重采样是把一份 DEM 的值搬到另一套格网上。工程里真正碰到的情形通常只有两种,一种是把格网变密,一种是把格网变粗。
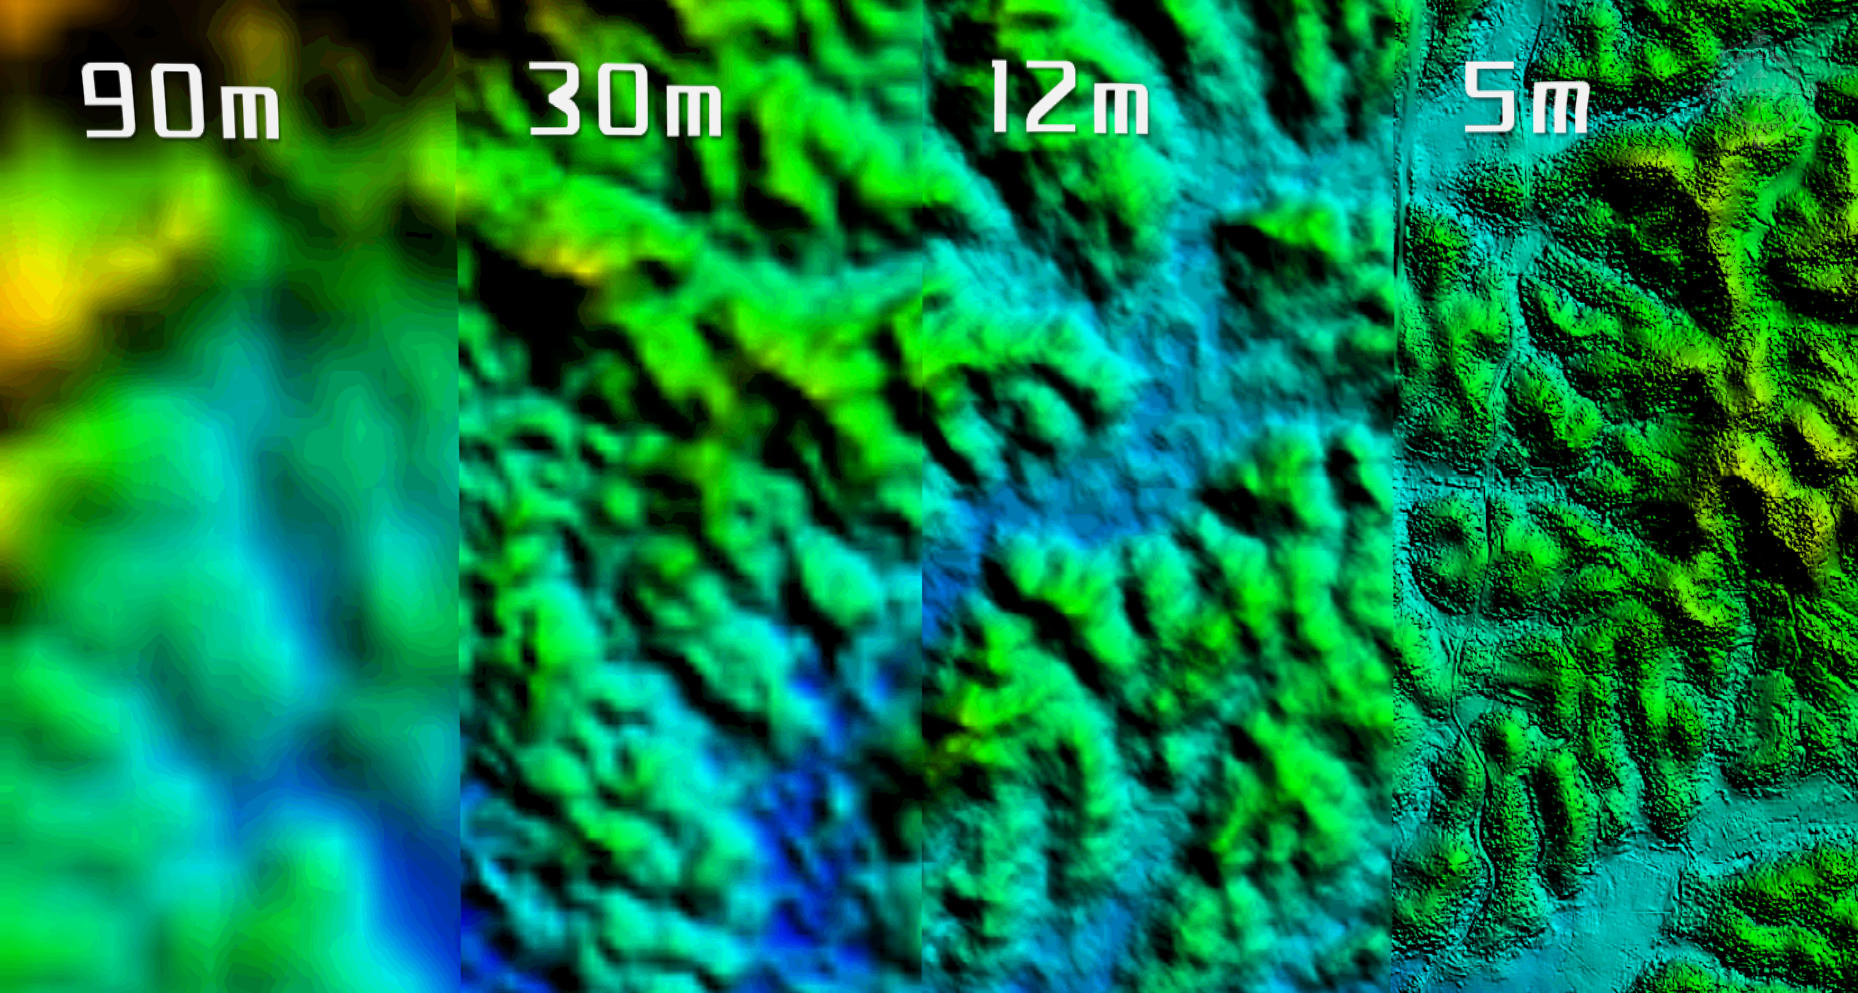
情形一:格网变密。常见场景是把 30 米档的区域数据转到 10 米格网,为的是与项目里其它 10 米格网的成果对齐,叠在一张图上不至于一格一格错开。这一步要认清一件事:格网变密不增加信息,只是把格网线对齐。目标格网写 10 米,值的可信程度仍是原来那一档。这句话写进说明里,比事后解释省事得多——尤其是当有人拿这张图去量一条冲沟的宽度时。
情形二:格网变粗。反过来,把项目上 2 米或 5 米的成果汇总到 30 米,做区域底图,或者与区域数据同网格叠加。这时候要定一件事:一个粗格网取细格网里的哪个值。取平均、取中值、取最低,三种都有人用,选哪种由后面拿它做什么决定——做汇水、做淹没、做土方,对同一个粗格网的要求并不相同。这里不做算法之间的比较,只强调一句:口径定了要写进说明,因为换一个口径,同一片地形算出来的量就变。
顺序:先定网格,再动手。目标网格有五个参数要先写下来:原点、格网间距、行列数、覆盖范围、无效值标记。五个参数定完,再决定怎么把值搬过去。反过来做——先重采样、再拉到目标网格上对齐——等于做了两次重采样,前一次的结果被后一次抹掉一半,出了偏差也追不回是哪一步。
还有一条与接边直接相关:重采样的边缘要靠邻幅。上一节引的那句提醒说的就是这个意思——只给目标范围的数据,边缘一圈没有邻幅参与,算出来的值不可靠。所以取数范围要按目标范围外扩一圈,算完再裁回来,别嫌多取的那一圈浪费。
工具推荐:文中这类多源地形数据的导入、格网对齐与叠加核对,图新说支持地形数据导入,以及坡度、高差等与地形相关的量测分析,可查阅产品文档了解具体操作。
三、最后
五项检查不是流程里新增的一道关卡,它是一张单子:拼之前照着念一遍,每一项后面写一句结果。写"是"或"否"都不重要,重要的是写下来的是当时看到的东西,而不是事后回忆的印象。
顺序也是单子的一部分。基准在前,接边在中,命名与版本在后——前两项决定数据是什么,第三、第四项决定拼完是什么样,最后一项决定这份东西以后还认不认得出来。顺序颠倒过来也能查完,但查完的结果不容易放在一起比。
检查花的是半小时,返工花的是半天到两天,而且返工常常不是改一个参数,是把整条链重走一遍:重新确认哪几幅参与、重新对基准、重新定接边、重新定网格。这也是为什么要把检查放在动手之前——动手之后,前面每一步的结论都已经被新数据覆盖,想回去核也没有对照物了。
图新说 —— 工程管理数字沙盘——看现场 · 做方案 · 管过程 · 定决策 · 存档案
中科图新 | 让每一寸空间都有数字灵魂
参考来源: